AI jest częścią mojej codziennej pracy od dawna — ale deklaracja niewiele znaczy, więc pokażę projekt. ZapiszPrzepis zbudowałem od zera i wdrożyłem na produkcję: aplikacja działa, kod jest publiczny, a jako praca zaliczeniowa kursu 10xDevs 3.0 przeszła w pierwszym terminie i dostała wyróżnienie Best Project.
To wciąż wersja testowa, ale od sierpnia, gdy napisałem pierwszą wersję tego wpisu, urosła z prywatnej kolekcji w publiczną bazę przepisów: przybyło ponad 300 commitów, a goście czytają przepisy bez konta.
Ten wpis jest o tym, jak wygląda ten proces w praktyce — bo to jest rzecz, którą wnoszę do każdego projektu klienckiego, a nie tylko do własnych zabawek. Samą aplikację, jej funkcje i to, co się w niej zmieniło, opisuję osobno, w case study ZapiszPrzepis.
Co robi aplikacja
Przepisy krążą dziś jako posty, Reelsy i filmy. Odruch jest jeden: zapisać zakładką albo funkcją „Zapisz” w danej platformie. Problem w tym, że wszystkie te sposoby przechowują odnośnik, a nie treść.
Po kilku miesiącach spora część zapisanych linków przestaje działać. Autor kasuje Reela, grupa kulinarna znika, blog gaśnie, post idzie w prywatne. Zapisana kolekcja zamienia się w listę błędów 404 — i dowiadujesz się o tym dopiero wtedy, gdy chcesz z niej skorzystać.
ZapiszPrzepis działa odwrotnie — archive-first. Z każdego linku robi trwałą kopię: tytuł, składniki, kroki i zdjęcie lądują w bazie użytkownika. Adres źródła zapisuje się razem z nimi, więc do oryginału wracasz jednym kliknięciem — dopóki istnieje. Kiedy zniknie, nie tracisz nic poza tym przyciskiem.
Ta kopia nie jest zrzutem strony. Tekst układa model OpenAI — zostawia składniki i kroki, a wycina nawigację, reklamy i długi wstęp, przez który trzeba się przewijać do właściwego przepisu. Angielskie źródła tłumaczy przy okazji na polski.
Projektowałem dla osoby nietechnicznej — takiej, która nie wpisuje ręcznie składników, nie wypełnia formularzy i nie zarządza folderami ani tagami. To ograniczenie okazało się najbardziej użytecznym filtrem w całym projekcie: natychmiast wykluczyło większość „oczywistych” funkcji.
Jak to działa
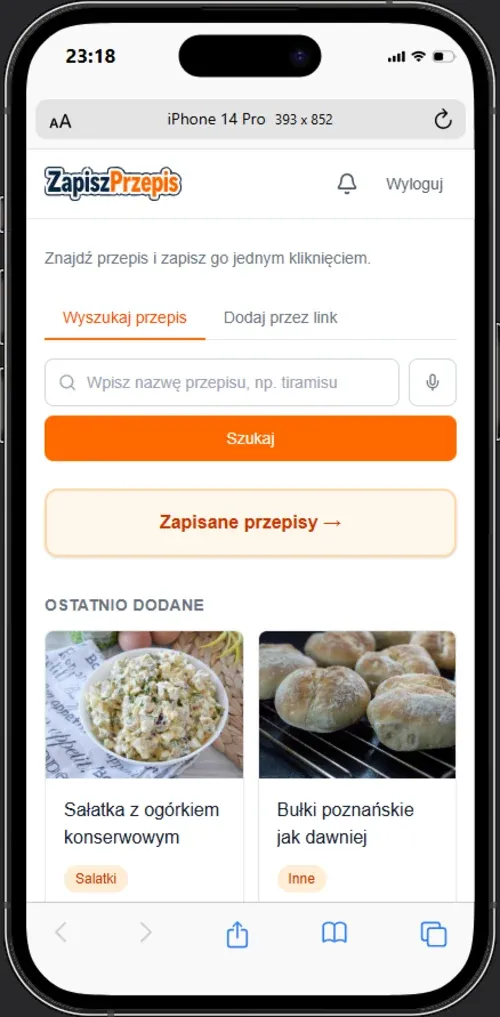
Cała ścieżka wejścia to jeden gest. Aplikacja rejestruje się jako Web Share Target, czyli pojawia się na systemowej liście „Udostępnij” obok Messengera i WhatsAppa. Użytkownik wysyła do niej link i nie robi nic więcej.
Dalej wszystko dzieje się w tle:
- Krok 1
Rozpoznanie źródła
Inaczej traktowany jest wpis na blogu, inaczej film, inaczej post w social mediach.
- Krok 2
Pobranie treści
Przez Firecrawl, a dla blogów na Bloggerze przez ich feed JSON — deterministyczny wynik zamiast zgadywania ze scrapowanego HTML-a.
- Krok 3
Ekstrakcja
Model OpenAI wyciąga tytuł, składniki, kroki i kategorię, a źródła anglojęzyczne tłumaczy na polski. Drugi, mocniejszy przebieg nadaje etykiety i tagi.
- Krok 4
Archiwizacja zdjęcia
Obrazek ląduje we własnym storage, żeby nie zniknął razem ze źródłem.
- Krok 5
Zapis
Gotowy przepis trafia do bazy z izolacją per użytkownik.
Ekstrakcja potrafi trwać kilkanaście sekund i bywa zawodna, więc nie działa w cyklu żądania. Wrzuca zdarzenie do Inngest, który zajmuje się kolejkowaniem i ponawianiem. Użytkownik dostaje odpowiedź natychmiast, a przepis dopisuje się chwilę później.
Później doszła jeszcze wyszukiwarka przepisów w internecie z wejściem głosowym — bo samo archiwizowanie rozwiązywało tylko połowę problemu. Druga połowa to znalezienie czegoś, czego jeszcze nie masz. Pełną listę funkcji, reguł redakcji przepisów i obsługiwanych źródeł znajdziesz w case study.
Stack i dlaczego akurat taki
Jedna decyzja zdeterminowała pozostałe: hosting na Cloudflare Workers oznacza brak Node.js API w runtime. Każda integracja musiała działać przez zwykły fetch. To wykluczyło kilka bibliotek, zanim napisałem pierwszą linijkę — i dobrze, bo odkrycie tego w trakcie wdrożenia kosztowałoby jeden z niewielu dostępnych dni.
Wybór między Next.js a lżejszymi generatorami rozbieram dokładniej w porównaniu frameworków do aplikacji webowych — tutaj przeważyła potrzeba dynamicznego stanu po stronie serwera.
Jak wygląda u mnie praca z AI
Sposób, w jaki pracuję z AI, przenosi się na projekty klienckie jeden do jednego.
Kontekst projektu jako pamięć długoterminowa
W repozytorium leży katalog z opisem wymagań, roadmapą, planami poszczególnych zmian i rejestrem wyciągniętych wniosków. To nie jest dokumentacja pisana dla ludzi po fakcie — to materiał wejściowy dla modelu przed każdą zmianą.
Różnica jest odczuwalna. Model bez kontekstu generuje kod, który wygląda rozsądnie, ale ignoruje decyzje podjęte trzy dni wcześniej. Model z wymaganiami i planem pod ręką proponuje rozwiązania spójne z tym, co już istnieje — i sam zwraca uwagę, gdy prosisz go o coś, co przeczy wcześniejszemu ustaleniu.
Dla Ciebie jako klienta ma to prozaiczny skutek: te dokumenty zostają. Nie kupujesz czarnej skrzynki, tylko projekt, w którym widać, co i dlaczego zostało zdecydowane.
Plan przed kodem, zawsze
Każda większa zmiana zaczyna się od dokumentu z rozpisanymi fazami, kryteriami akceptacji i listą ryzyk — a nie od polecenia „dodaj wyszukiwarkę”. Dopiero zatwierdzony plan idzie do implementacji.
Brzmi jak biurokracja. W praktyce to właśnie ten krok skraca całość, bo eliminuje najdroższą kategorię błędów: zbudowanie czegoś działającego, co rozwiązuje niewłaściwy problem. Wyszukiwarka z lipca to dobry przykład — miała budżet tygodnia, a powstała w trzy dni, bo plan był gotowy, zanim poszła pierwsza linijka.
Od prototypu do kodu: wycinki ze specyfikacją
Przebudowa aplikacji na publiczną bazę przepisów to epik rozpisany na ponad 30 wycinków (E01-S01 i dalej), zapisanych jako zgłoszenia w GitHubie. Każdy wycinek ma własną specyfikację w repozytorium i trafia do niej osobnym PR-em przed implementacją: najpierw „specyfikacja trybu gotowania”, dopiero potem sam tryb gotowania. Wygląd wychodzi z klikalnego prototypu i kolejnych wersji przekazania projektu, a po wdrożeniu przechodzę audyt luk: porównuję to, co działa, z końcowym przekazaniem projektu, ekran po ekranie.
Wniosek jest ten sam co wyżej, tylko w większej skali: gdy model dostaje wycinek ze specyfikacją i kryteriami akceptacji, nie wymyśla produktu po drodze.
Testy tam, gdzie logika jest podstępna
Projekt ma ponad 160 plików testów jednostkowych i testy E2E w Playwrighcie. Nie są rozłożone równomiernie i to jest celowe — stoją tam, gdzie najłatwiej o cichą pomyłkę: rozpoznawanie typu źródła, normalizacja linków, redakcja składników, deduplikacja, ocena czy pobrana treść w ogóle nadaje się na przepis, parsowanie identyfikatorów filmów. Testy układu przy 320 px (kryterium WCAG o przewijaniu) wpiąłem w bramkę przed scaleniem, bo wcześniej po cichu „zgniły” i zaczęły sprawdzać nieaktualne rzeczy.
O tym, jak wpinam AI w testy E2E, pisałem szerzej w przewodniku po testach E2E z Playwrightem.
Review jako bramka, nie formalność
Kod, przy którym pomagał model, rzadko myli się w sposób oczywisty. Myli się tam, gdzie coś działa, ale opiera się na błędnym założeniu: wyrażenie regularne, które wygląda na szczelne. Dopasowanie, które działa dla dzisiejszych danych wejściowych. Uprawnienie nadane „na wszelki wypadek”.
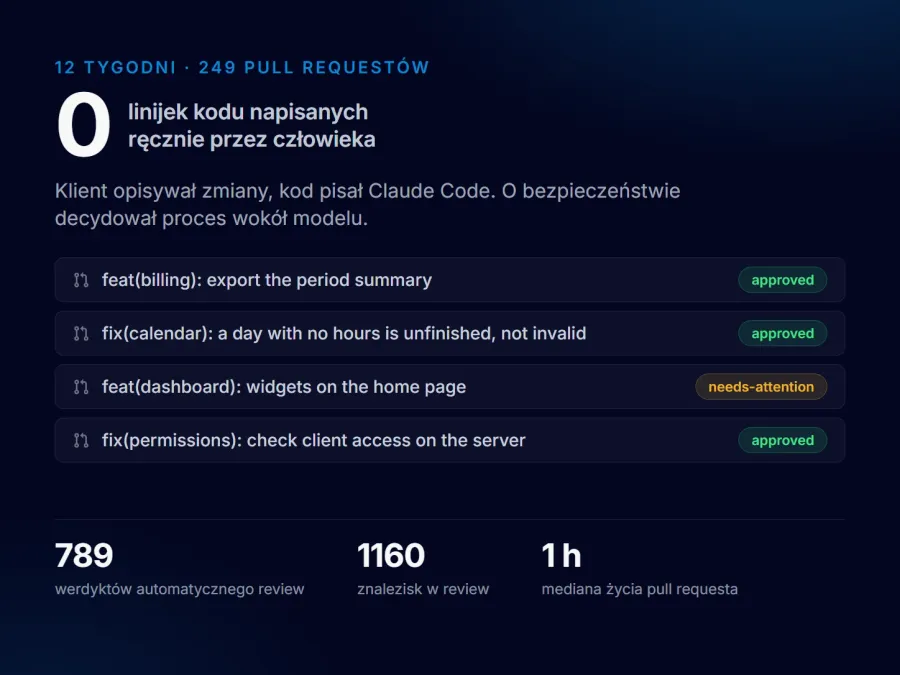
To są dokładnie te rzeczy, które przechodzą przez kompilator i przez testy. Dlatego review nie jest u mnie ostatnim punktem listy, tylko miejscem, w którym spędzam nieproporcjonalnie dużo czasu — i im więcej kodu pisze model, tym bardziej to się opłaca. Jak to wygląda, gdy review jest w całości automatyczne, a kod pisze wyłącznie model, opisałem w tekście co się dzieje, gdy kod pisze wyłącznie AI.
Potok agentów i bramki
Do repozytorium dołożyłem zestaw skilli Open Mercato (jest ich 42) i skonfigurowałem z nich potok pracy nad zmianami. Skille leżą w samym repozytorium, więc działają tak samo na każdym komputerze. Zasady spisują trzy dokumenty: SDLC.md (droga od zgłoszenia do scalonego PR-a), CODE_REVIEW.md (lista kontrolna przeglądu) i BACKWARD_COMPATIBILITY.md (co jest kontraktem, którego nie wolno zepsuć).
Zmiana przechodzi przez stałe etapy: zgłoszenie, sprawdzenie, czy błąd jest prawdziwy i jeszcze niezałatwiony, przejęcie zadania (żeby dwaj agenci nie robili tego samego), wdrożenie z testami regresji, PR, przegląd, a przy zmianach widocznych dla użytkownika sprawdzenie w prawdziwej przeglądarce. Dla agentów powstała osobna trasa logowania testowego, dostępna tylko w środowisku deweloperskim. Repozytorium ma jedno konto, więc zasada brzmi uczciwie: przeglądam własne PR-y, a scalam dopiero przy zielonych testach.
Audyt kodu zamiast zaufania
Po przebudowie zrobiłem audyt kodu, który zamienił się w kolejne backlogi (E02, E03). Pierwszy wycinek zamknął realną lukę: zapis do tabeli przepisów i importów odebrałem sesji użytkownika, zostawiając go roli serwisowej. To dokładnie ta kategoria błędów, o której piszę wyżej: nic się nie sypało, aplikacja działała, a uprawnienie było szersze, niż trzeba.
Wyjście modelu to dane z zewnątrz
Model w produkcie to osobny temat od modelu, który pisze kod. Tryb JSON gwarantuje poprawny JSON, ale nie pola, o które prosił prompt. Składnik bez nazwy wywalał deduplikację, a czas typu „15-20” albo 37,5 nie wchodził do kolumny liczbowej, więc cała, już opłacona, ekstrakcja szła do kosza. Dlatego odpowiedź modelu przechodzi przez strażników kształtu, zanim cokolwiek zapiszę.
Tak samo z redakcją kroków: reguły leżą w jednym miejscu i używa ich zarówno wyciąganie nowych przepisów, jak i skrypt poprawiający stare, a poprawka starego przepisu jest odrzucana, jeśli zmienia liczbę kroków albo jakąkolwiek liczbę w treści. Czas, którego źródło nie podaje, jest oznaczany jako szacunkowy. Szczegóły reguł opisuję w case study.
Własne testy zamiast rankingów
Model do wyciągania przepisów wybieram na własnych danych. Pierwszy test porównał pięć modeli OpenAI na 26 przepisach i pokazał, że gpt-5.4-mini ma mniej więcej o połowę mniej naruszeń reguły miary domowej, prawie nie łamie formy kroków i jest najszybszy, więc zmiana była jednolinijkowa. Potem sprawdziłem 21 modeli na polskich i angielskich przepisach, z wzorcem zweryfikowanym ręcznie, na ślepo. Wniosek jest nieoczywisty: czołówka to statystyczny remis, droższy model nie wypadł lepiej, a to, u którego dostawcy model działa, zmienia wynik bardziej niż jego rozmiar. Pełny opis metody i wyniki są w osobnym tekście: który model AI najlepiej zapisuje przepisy.
Produkcja weryfikuje
Próba przyspieszenia aplikacji przez uruchomienie Workera blisko bazy (Smart Placement) skończyła się tym, że produkcja zaczęła zwracać błędy 503, więc zmianę cofnąłem tego samego dnia. Dwa dni później włączyłem ją ponownie, ale już jako próbę: z zapisanym warunkiem, że mierzę czas odpowiedzi przed i po i cofam, jeśli nie ma zysku. Wniosek zapisałem jako stałą bramkę: po wdrożeniu skrypt sprawdza, czy pliki statyczne naprawdę się ładują, i zgłasza sporadyczne błędy stron. Zielone testy lokalne nie są dowodem, że produkcja działa.
Co z tego ma Twój projekt
Konkretnie, bez ogólników:
- Wymagania spisane przed kodem. Wiesz, co powstaje i po czym poznamy, że jest gotowe.
- Szybsze dojście do działającej wersji. AI skraca pisanie, więc więcej czasu zostaje na to, co realnie decyduje o wyniku.
- Testy w miejscach, które psują się po cichu. Nie po to, żeby mieć ładny wskaźnik pokrycia, tylko żeby regresja nie dojechała do produkcji.
- Kod i dokumentacja u Ciebie. Repozytorium, decyzje i historia zmian są Twoje — możesz z tym pójść dalej, ze mną albo bez.
- Jedna osoba odpowiedzialna za całość. Od architektury, przez wdrożenie, po wsparcie po starcie.
Podsumowanie
- AI nie zastępuje myślenia, tylko skraca pisanie. Cała różnica robi się na etapie, na którym ustalamy, co w ogóle budujemy.
- Kontekst projektu w repozytorium jest infrastrukturą, nie dokumentacją — i zostaje u klienta.
- Review i testy zyskują na znaczeniu, im więcej kodu pisze model, bo błędy przesuwają się z „nie kompiluje się” w stronę „działa, ale na błędnym założeniu”.
- Ograniczenia platformy warto poznać przed pierwszą linijką, a nie w trakcie wdrożenia.
- Wyjście modelu w produkcie jest daną z zewnątrz, więc trzeba je walidować tak jak każde inne.
- Specyfikacja per wycinek i spisane bramki pozwalają agentom pracować równolegle bez rozjeżdżania się.
Co powstało z tego procesu, czyli funkcje, publiczna baza przepisów, dostępność i widoczność w wyszukiwarkach, opisuję w case study ZapiszPrzepis.
ZapiszPrzepis powstał w ramach 10xDevs 3.0, został zaliczony w pierwszym terminie z wyróżnieniem Best Project — certyfikat do weryfikacji — a kod jest publiczny na GitHubie.