llms.txt
llms.txt to plik w Markdownie w katalogu głównym serwisu, listujący jego ważne podstrony z jednym zdaniem o każdej, pomyślany do czytania przez modele językowe, a nie przez przeglądarki. To propozycja społeczności, nie standard, do którego zobowiązał się jakikolwiek crawler.
Co to jest
Jeden plik w Markdownie pod adresem /llms.txt, listujący podstrony warte przeczytania, każdą z linijką mówiącą, co w niej jest. Opcjonalnie drugi plik, llms-full.txt, z dużo większą częścią treści w środku.
Pomysł wyrasta z tego samego miejsca co robots.txt: model zapytany o twoją firmę ma ograniczony budżet podstron do pobrania, a HTML jest drogim sposobem na jego wydanie — nawigacja, skrypty, znaczniki, baner cookies i gdzieś pośrodku odpowiedź. Wyselekcjonowany indeks czystego tekstu czyta się taniej i łatwiej cytuje.
Ile o tym uczciwie powiedzieć
Wszystko, bo tę część większość tekstów o llms.txt pomija: żaden duży crawler AI nie zobowiązał się, że go czyta. To propozycja z realnym rozpędem i bez żadnej gwarancji. Kto mówi, że dzięki temu wejdziesz do odpowiedzi ChatGPT, coś ci sprzedaje.
Robić to mimo wszystko warto z powodu kosztu. Na tej stronie cztery pliki — angielski i polski, krótki i pełny — powstają z kolekcji treści w trakcie budowania. Nikt ich nie pisze, nikt nie aktualizuje, a nowy wpis albo nowa podstrona trafia do właściwego sama. Bramka w buildzie pada, jeśli strona z sitemapy nie jest podlinkowana z indeksu w swoim języku. To błąd zaokrąglenia w nakładzie pracy wobec korzyści, która może przyjść.
Gdyby trzeba było utrzymywać to ręcznie, odpowiedź byłaby inna.
Co w nim jest
Indeks ma sens tylko wtedy, gdy to, na co wskazuje, też czyta się tanio — dlatego jedno idzie tu z drugim: każda podstrona z sitemapy wydaje swój odpowiednik w czystym Markdownie pod tym samym adresem z sufiksem .md, a każda linijka llms.txt go nazywa. Nagłówki w tych plikach noszą te same kotwice co strona HTML, więc model cytujący jedną sekcję może podać adres, który zadziała też człowiekowi.
Każdy język ma własny, kompletny indeks, linkujący tylko swoje podstrony i wskazujący na ten drugi. Jeden plik dwujęzyczny byłby trudniejszy w czytaniu i niekompletny z obu stron.
Czym llms.txt nie jest
Nie jest sygnałem rankingowym, nie czyta go wyszukiwarka Google i nie zastępuje ani sitemapy, ani danych strukturalnych. Nie jest też miejscem na tekst marketingowy: plik istnieje po to, żeby maszyna znalazła zdanie odpowiadające na pytanie, a dokładanie przymiotników pogarsza go w dokładnie tym jednym.
Powiązane pojęcia
Zobacz też
Chcesz to mieć zrobione, a nie tylko zdefiniowane?
To jest ta część pracy, do której się mnie wynajmuje. Na stronie niżej jest, ile to kosztuje i jak przebiega.
Audyt widoczności w AIGdzie o tym piszę
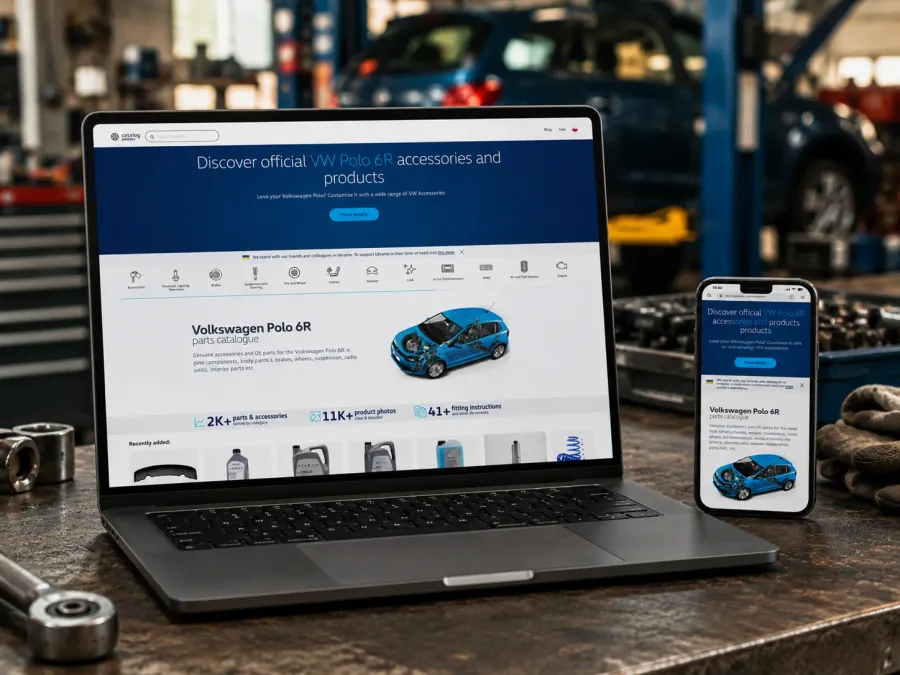
Katalog części i akcesoriów
Katalog części OEM do VW Polo 6R oparty na headless CMS. Frontend Astro SSG, Vue 3, backend Laravel REST API, panel Filament, tłumaczenia DeepL i opisy AI.
AEO — jak zoptymalizować stronę pod AI i Answer Engines
Answer Engine Optimization, llms.txt, architektura wysp i szybkość jako waluta konwersji. Praktyczny przewodnik po optymalizacji stron pod modele językowe i wyszukiwarki generatywne.