Problem: zapisany link to nie przepis
Przepisy krążą jako posty, rolki i filmy. Odruch to zakładka albo przycisk „Zapisz” na platformie, ale oba przechowują wskaźnik, nie treść. Po kilku miesiącach część zapisanych linków przestaje działać: autor kasuje rolkę, grupa znika, blog przestaje istnieć, post staje się prywatny. Kolekcja zamienia się w listę błędów 404, a człowiek dowiaduje się o tym wtedy, gdy chce z niej skorzystać.
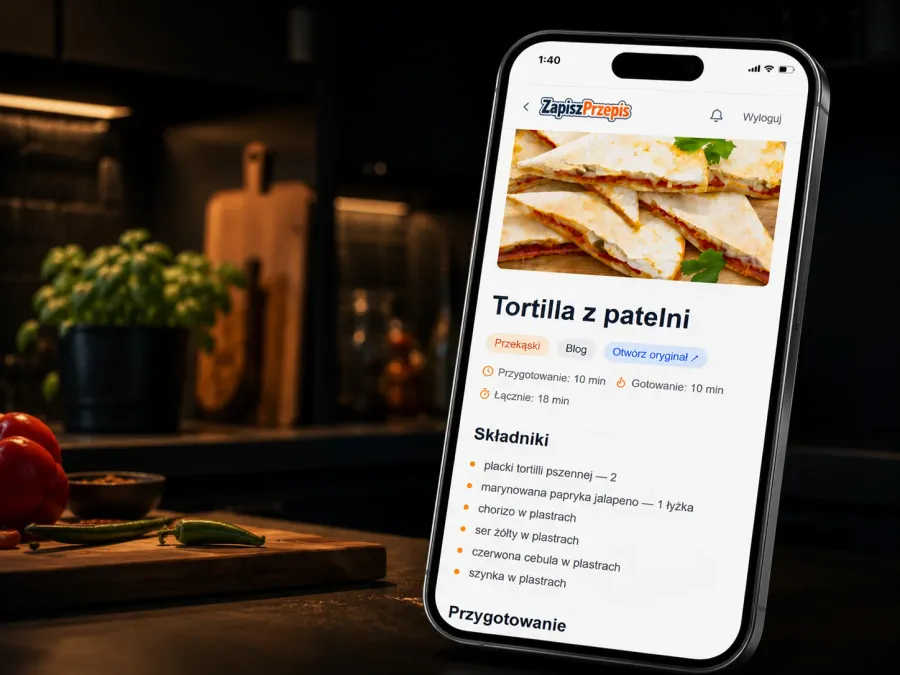
ZapiszPrzepis działa odwrotnie, w modelu archive-first. Link zamienia się w trwałą kopię przepisu w bazie, a adres źródła zostaje obok, żeby oryginał był o jedno kliknięcie dalej, dopóki istnieje.
Projektowałem to dla osoby nietechnicznej, która nie wpisuje składników ręcznie, nie wypełnia formularzy i nie układa folderów ani tagów. Ten warunek wyciął większość „oczywistych” funkcji i okazał się najlepszym filtrem w całym projekcie.
To ciąg dalszy wpisu o tym, jak pracuję z AI na prawdziwym projekcie. Tamten tekst opisuje metodę: specyfikacje przed kodem, bramki, testy. Ten opisuje produkt: co zbudowałem, jak działa i co zmieniło się od sierpnia, gdy zaczęto z niego naprawdę korzystać.
Z prywatnej kolekcji do publicznej bazy
Pierwsza wersja była prywatną kolekcją jednego użytkownika. Największa zmiana od sierpnia to przebudowa na publiczną bazę przepisów.
- Jeden link, jedna strona. Każdy przepis ma publiczny adres
/przepis/{slug}. Dodanie linku, który już jest w bazie, nie tworzy duplikatu, tylko dodaje istniejący przepis do ulubionych. Scalone duplikaty przekierowują (301) na przepis, który został. - Goście czytają bez konta. Strona główna, przepisy, kategorie i wyszukiwarka są otwarte. Dostęp do danych dla gości idzie przez widoki, które domyślnie niczego nie ujawniają, więc pomyłka w uprawnieniach kończy się brakiem danych, a nie wyciekiem.
- Konto daje własną kolekcję. Ulubione, lista „Moje przepisy” i publiczny profil pod
/u/{nazwa}. Dodawanie przepisów z linków jest za kodem dostępu. - Wiele wersji tego samego dania. Przepisy na to samo danie są grupowane („Mamy jeszcze 2 inne przepisy na krokiety”), a różnice w składnikach oznaczone kolorem. Podobne przepisy nie podsuwają dań mięsnych osobie, która ogląda bezmięsne.

Jak to działa
Wejście to jeden gest. Aplikacja rejestruje się jako Web Share Target, więc pojawia się w systemowym menu „Udostępnij” obok Messengera i WhatsAppa. Użytkownik wysyła link i na tym kończy.
- Krok 1
Rozpoznanie źródła
Post na Facebooku, rolka, film z YouTube i blog to cztery różne przypadki, każdy z własnym sposobem pobrania treści.
- Krok 2
Sprawdzenie duplikatu
Ten sam przepis opublikowany dwa razy nie trafia do bazy drugi raz, nawet pod innym adresem.
- Krok 3
Pobranie treści
Wiele dróg i zapasowe plany, gdy pierwsza zawiedzie.
- Krok 4
Redakcja
Model wyciąga przepis i porządkuje go według stałych reguł.
- Krok 5
Kontrola
Bez składników albo bez kroków nic nie trafia do bazy, a w powiadomieniach pojawia się informacja, że na stronie nie ma przepisu.
- Krok 6
Etykiety
Drugi, mocniejszy przebieg nadaje tytułowi właściwą formę, dodaje tagi i opis.
- Krok 7
Zapis
Przepis trafia do bazy, a zdjęcie do własnego magazynu.
Wyciąganie przepisu trwa kilkanaście sekund i bywa kapryśne, więc nie dzieje się w trakcie żądania. Aplikacja wysyła zdarzenie do Inngest, który ustawia zadanie w kolejce i ponawia je przy błędzie. Użytkownik dostaje odpowiedź od razu, a przepis pojawia się chwilę później. Jeśli import się nie uda, powód trafia do powiadomień i można go ponowić stamtąd. Import zawieszony w stanie „oczekuje” jest traktowany jako nieudany, żeby nic nie wisiało w nieskończoność.
Redakcja: z posta do przepisu
Samo zapisanie treści nie wystarcza. Post z Facebooka to zwykle narracja („pokroiłam, zeszkliłam, dodałam”), pełna wtrętów i zachęt. Przepis w aplikacji ma wyglądać tak samo niezależnie od źródła, więc reguły redakcji są częścią produktu.
- Kroki to krótkie polecenia w bezokoliczniku: „Pokroić mięso w kostkę.”, „Zeszklić cebulę.”. Narracja i tryb rozkazujący są przepisywane na tę formę, znikają wtręty typu „u mnie” i słowa „następnie”, „potem”, „na koniec”, bo kroki są numerowane. Słowa mówiące o czasie („gdy woda się zagotuje”) zostają. Przepisy zapisane wcześniej poprawia osobny skrypt (w wydaniu 0.2.0 objął 609 z nich), a nowe dostają tę formę od razu.
- Kolejność poprawiana tylko tam, gdzie trzeba. Składnik, który źródło przygotowuje po kroku, który go używa (lukier, kruszonka, sos), przesuwam przed ten krok. Końcowe „Smacznego!” wypada, a porady o przechowywaniu i wariantach trafiają do jednego kroku „Opcjonalnie:”.
- Nic nie jest dopisywane. Gdy post podaje składniki, a metodę zostawia filmowi, kroki zostają puste. Czasu, którego źródło nie podaje, model może się domyślić, ale wtedy jest on oznaczony jako szacunkowy. Liczby porcji nie szacuję wcale.
- Źródła obcojęzyczne. Przepis z angielskiej strony dostaje polskie nazwy produktów (makarony jako „literki”, „kółka”, „małe rurki”) i polskie sformułowania bez kalk, a amerykańskie oznaczenia w rodzaju „94% chude” są upraszczane do „chude”. Miary amerykańskie są przeliczane na metryczne.
- Miary domowe. Gdy źródło podaje obok wagi miarę z kuchni („250 g mąki – ok. 1,5 szklanki”), pokazuję ją jako drugą, jaśniejszą linię pod ilością. Model przepisuje ją dosłownie ze źródła i nigdy jej nie szacuje. Dla podstawowych produktów sypkich miarę domową wylicza osobno sama aplikacja, z tabeli gęstości, tylko przy wyświetlaniu.
- Pozostałe porządki: tytuł jak w menu (bez „Jak zrobić…”, bez „najlepszy”, bez pierwszej osoby), sekcje składników (Ciasto, Krem, Masa), jednostki amerykańskie przeliczone na metryczne, kategoria według reguł (ciasteczka, ciasta, pieczywo, syropy i kolejne).
Dwa przebiegi to świadomy podział kosztów. Tańszy model wyciąga treść, a mocniejszy, który dostaje jeden gotowy przepis, nadaje etykiety i tagi. Z tańszym tagi wychodziły źle: oznaczał bułki i pizzę jako „kruche”. Model do wyciągania treści wybieram na własnych testach, nie z rankingu: po teście na przepisach przeszedłem na gpt-5.4-mini, a szerszy test 21 modeli na polskich i angielskich przepisach potwierdził ten wybór (czołówka to statystyczny remis).
Jak wybrałem model: test 21 modeli AI na 50 polskich i angielskich przepisach, z wzorcem sprawdzonym ręcznie, metodą i wynikami.
Źródła i zapasowe plany
Pierwsza wersja czytała blogi i YouTube. Od tamtej pory największa część pracy poszła w to, żeby link „po prostu działał”, bo w praktyce źródła zawodzą na różne sposoby.
Do tego dochodzi deduplikacja w kilku warstwach. Ten sam link znany pod kilkoma adresami (udostępnienie z aplikacji Facebooka, stały link do posta, nazwa grupy w innej formie) dostaje jeden klucz. Powtórka tego samego autora jest wyłapywana po odcisku jego tekstu, jeszcze zanim zostanie wywołany model, a ta, która różni się tekstem, po prawie identycznym zestawie składników (także wtedy, gdy dwa zapisy trafiają niemal jednocześnie).
Zdjęcia i źródła na kartach
Zdjęcie przepisu to osobny problem. Pierwszy obrazek na stronie bywa logo, reklamą albo miniaturą innego przepisu.
- Okładka i galeria wybierane z treści. Odrzucam zdjęcia z sekcji reklam, powiązanych wpisów i komentarzy, przyciski, logotypy sklepów, miniatury filmów i obrazki, które są linkiem do innej strony. Dla blogów ze złym
og:imagewybieram właściwe zdjęcie sam. - Kopia zdjęć u siebie. Okładka i galeria są archiwizowane w magazynie aplikacji, bo adresy z Facebooka wygasają w ciągu dni. Okładki z hostów z błędem SSL albo odrzucających ruch z Cloudflare są odzyskiwane osobną drogą.
- Zdjęcia kroków. Gdy źródło ma zdjęcie przy konkretnym kroku, jest ono pokazywane przy tym kroku (dla zalogowanych).
- Skąd jest przepis. Plakietka źródła pokazuje logo Facebooka i autora albo domenę bloga. Osoba prywatna występuje tylko jako imię i inicjał nazwiska, bo pełnego nazwiska nigdy nie zapisuję.
Wygoda na co dzień


- Tryb gotowania. Pokazuje jeden krok na pełnym ekranie, dużą czcionką, z paskiem postępu i przyciskami „Wstecz” i „Dalej”, a ekran telefonu nie gaśnie w trakcie (Wake Lock), bo przy mące na rękach nikt nie chce go odblokowywać. Na samej stronie przepisu składniki mają pola wyboru: zaznaczony składnik się przekreśla, a „Wyczyść zaznaczenia” zeruje listę.
- Wyszukiwanie. Jedna wyszukiwarka z zakresem „wszystkie / moje / ulubione”, podpowiedziami podczas pisania, ostatnimi wyszukiwaniami i głosem (przycisk „Powiedz” i ekran „Słucham…”). Osobno wyszukiwarka przepisów w internecie, która korzysta tylko z zaufanych stron i ma limit zapytań na minutę.
- Kategorie i tagi. Kategorie z licznikami, a w kategorii wybór kilku tagów naraz, które zawężają listę (przepis musi mieć wszystkie wybrane).
- Ulubione. Serce z podpisem na kartach i na zdjęciu, osobna lista. Kliknięcie przez osobę niezalogowaną zapamiętuje zamiar i dokańcza go po zalogowaniu.
- Drukowanie. Przycisk „Drukuj” i osobny arkusz stylów do druku: składniki i kroki w dwóch kolumnach, małe zdjęcie przy nagłówku, bez linii źródła i bez zdjęć kroków.
- Przepis dnia na stronie głównej, który zmienia się o polskiej północy, a nie o północy UTC.
- Ustawienia wyglądu. Wielkość tekstu skaluje całą aplikację, razem z opisem przepisu. Ta strona jest dostępna także bez logowania, bo osoba, której drobny druk przeszkadza, powinna to zmienić, zanim się zaloguje. Do tego wybór koloru akcentu.
Dostępność i prawdziwy telefon
Aplikacja ma być czytelna dla osoby, która nie lubi małego druku, więc przebudowa publiczna szła pod WCAG 2.2 AA: duże cele dotykowe (48 px), brak przewijania w poziomie przy 320 px szerokości i przy powiększonej systemowej czcionce, przycisk „Wróć” zamiast gubienia się w nawigacji. Nazwy kategorii nie łamią się w środku słowa nawet przy dużej czcionce, a spójniki jednoliterowe („i”, „w”, „z”) nie zostają na końcu wiersza.
Testuję na dwóch telefonach z Androidem, Pixel 11 Pro i Pixel 9, jako zainstalowaną PWA, a nie tylko w oknie przeglądarki. To znalazło błędy, których emulator nie pokazuje: kolor paska systemowego i dolnej nawigacji na Androidzie, przez który przyciski mogły zniknąć na białym tle. Naprawiłem to ciemnym tłem w manifeście i dynamicznym theme-color.
Widoczność w wyszukiwarkach i dla modeli AI
- Dane strukturalne. Strony przepisów mają schema.org/Recipe w JSON-LD, dzięki czemu Google może pokazać przepis jako rozszerzony wynik.
- Opisy. Opis do wyników wyszukiwania powstaje przy zapisie przepisu, a kategorie mają własne tytuły, opisy i karty do udostępniania.
- Mapa strony i robots.txt. Search Console odczytał mapę dwa dni po wysłaniu (status Success) i znalazł w niej 824 adresy. Strony szybko pojawiły się w indeksie Google.
- Dla modeli językowych. Każdy przepis i każda kategoria ma wersję w Markdownie, a w katalogu głównym leży
llms.txtz listą stron, więc asystenci AI mogą cytować przepis z jego źródła, a nie ze zgadywania.
Logowanie i dostęp
Podstawą jest logowanie linkiem w mailu, bez hasła, który działa na dowolnym urządzeniu: link otwarty w innej przeglądarce niż ta, w której zaczęło się logowanie, nie kończy się już błędem. Doszło logowanie przez Google i przez Facebooka. Przycisk Facebooka czekał, aż aplikacja Meta przejdzie na tryb Live, i od 24 października jest włączony. Po pierwszym logowaniu aplikacja pyta raz o formę zwrotu, żeby powitać po polsku w wołaczu i napisać „Dodała” albo „Dodał” w publicznych tekstach, a nie „Witaj, Użytkowniku”.
Wylogowanie z jednego urządzenia nie wylogowuje już ze wszystkich, a chwilowy błąd sprawdzenia sesji nie wyrzuca użytkownika z aplikacji.
Bezpieczeństwo i niezawodność
- Odczyty gości fail-closed. Publiczne strony czytają dane przez widoki z listą dozwolonych pól, a granica tej listy ma własne testy.
- Zdjęcia przez listę dozwolonych. Optymalizator obrazów przepuszcza tylko zarchiwizowane zdjęcia przepisów, a adresy z sieci prywatnych są odrzucane przy pobieraniu.
- Zapisy tylko przez serwer. Zapis do tabeli przepisów i importów jest odebrany sesji użytkownika i zostaje przy roli serwisowej, więc zablokowanie dotyczy bazy, a nie tylko kodu aplikacji (po audycie kodu). Przekierowanie po logowaniu nie pozwala już wyskoczyć poza serwis.
- Nagłówki bezpieczeństwa ustawiane w warstwie pośredniej na każdej odpowiedzi.
- Service worker bez stron z konta. Tryb offline pokazuje zapisane publiczne strony albo komunikat „Offline”, ale strony zalogowanego użytkownika nie trafiają do pamięci podręcznej, a po wylogowaniu pamięć jest czyszczona. Wcześniej zapasowa ścieżka nie działała (zawsze brała pierwszą gałąź), więc to też była realna poprawka.
- Kopia zapasowa i czuwanie. Tabele z przepisami są zrzucane do R2 codziennie, a projekt w Supabase dostaje codzienne zapytanie, żeby nie zasypiał.
- Sprawdzenie produkcji. Po wdrożeniu skrypt sprawdza, czy pliki statyczne naprawdę się ładują, i zgłasza sporadyczne błędy stron.
Technologie
Hosting na Cloudflare Workers oznacza brak API Node.js w czasie działania, więc każda integracja musi działać na zwykłym fetch. To wyeliminowało kilka bibliotek jeszcze przed pierwszą linijką kodu.
Wnioski
- Archiwum kopii wygrywa z zakładką, bo przepis nie zależy od życia źródła.
- Reguły redakcji są produktem, nie dodatkiem. To one sprawiają, że przepisy z różnych źródeł czyta się tak samo.
- Źródła zawodzą po cichu, więc pomagają zapasowe plany, uczciwe komunikaty i powiadomienia z możliwością ponowienia.
- Jeden link, jedna strona pozwoliła zamienić prywatną listę w bazę, którą da się czytać, linkować i znaleźć w Google.
- Prawdziwy telefon znajduje to, czego nie widać na komputerze.
Jak do tego doszedłem, czyli specyfikacje przed kodem, potok agentów, audyt kodu i testy, opisuję we wpisie o pracy z AI.